
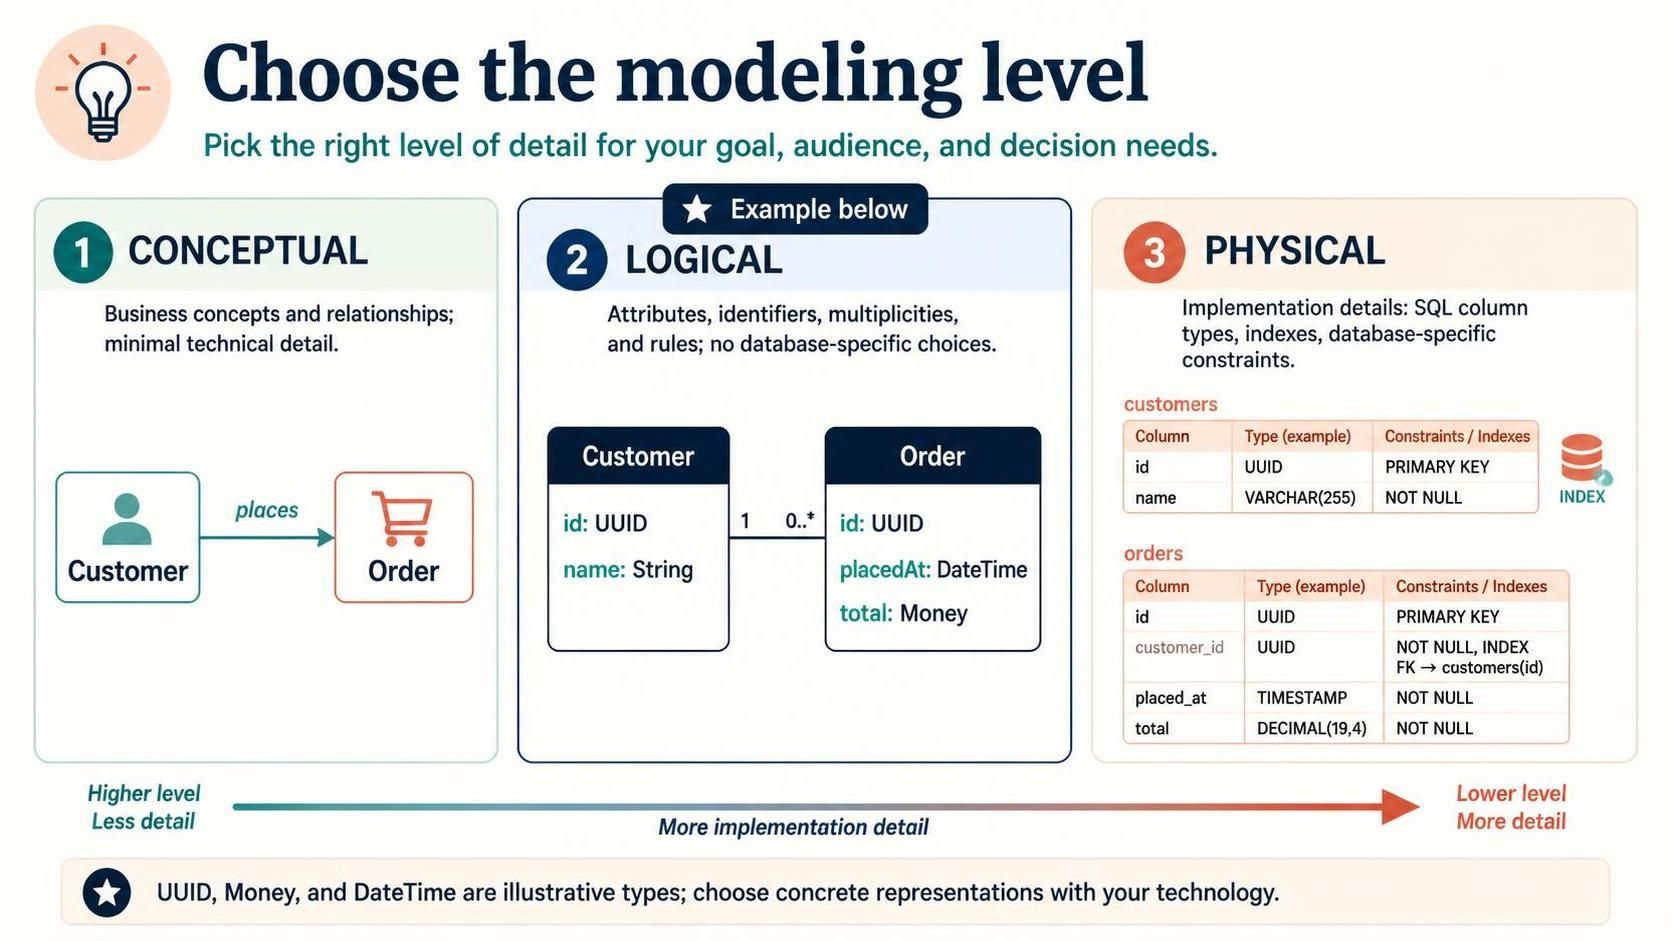
在软件工程和数据架构领域,数据建模不仅仅是画图表,它是连接业务需求与代码实现的桥梁。正如图片所示,优秀的建模实践通常要求我们在同一时间只关注一个层级。这有助于团队在不同阶段聚焦于不同的目标:是梳理业务逻辑,还是优化数据库性能?
本文将深入解析数据建模的三个核心阶段——概念模型、逻辑模型和物理模型,并通过一个“客户下单”的经典场景,带你一步步理解从抽象业务到具体SQL实现的演变过程。
1. 概念数据模型 (Conceptual Data Model)
概念模型是数据建模的起点,也是与业务利益相关者(如产品经理、业务分析师)沟通的最佳语言。它的主要目的是识别业务中的核心对象(实体)以及它们之间的关系。
- 核心特征:专注于业务概念,几乎不包含技术细节。
- 关键元素:实体(如 Customer、Order)和关系(如 places)。
- 目标受众:业务人员、系统架构师。
在图片左侧的示例中,我们看到了一个简化的关系图。这里没有属性,没有数据类型,只有简单的方框和箭头。它清晰地表达了:“一个客户 (Customer) 会发起一个订单 (Order)”这一核心业务规则。这种极简的抽象方式能够确保所有人对业务逻辑的理解是一致的,而不被技术细节干扰。
2. 逻辑数据模型 (Logical Data Model)
一旦业务概念被确认,我们就进入逻辑建模阶段。这是技术团队(如后端开发人员)开始介入的环节。逻辑模型描述了数据的结构和约束,但仍然保持“数据库无关性”。
根据图片中间部分的示例,逻辑模型包含了以下关键信息:
- 属性 (Attributes):实体现在有了具体的字段,例如
Customer有name,Order有total。 - 标识符 (Identifiers):定义了如何唯一标识一个记录,例如使用
UUID作为主键。 - 基数/多重性 (Multiplicities):定义了关系的具体数量规则。图片中的
1到0..*表示:一个订单必须属于一个客户,而一个客户可以拥有零个或多个订单。 - 规则 (Rules):业务逻辑的细化,例如订单必须有总价。
值得注意的是,逻辑模型中使用的数据类型(如 UUID, Money, DateTime)通常是抽象的或通用的。正如图片底部的注释所言:“这些类型是示例性质的;当你选择具体技术栈时,需要决定它们的具体表现形式。”
在 Visual Paradigm UML 中,我们可以使用 VPasCode 来快速生成这种逻辑模型。以下是一个简单的 VPasCode 代码示例,展示了如何定义上述逻辑结构:
class Customer {
    id: UUID
    name: String
}

class Order {
    id: UUID
    placedAt: DateTime
    total: Money
}

Customer "1" --> "0..*" Order : places3. 物理数据模型 (Physical Data Model)
物理模型是数据建模的最终阶段,也是直接指导数据库实施(如创建 SQL 脚本)的阶段。它将逻辑模型中的抽象类型“落地”为特定数据库(如 PostgreSQL, MySQL, Oracle)的具体实现。
观察图片右侧的物理模型部分,你会发现细节的显著增加:
- 实现细节:具体的 SQL 列类型。例如,
String变成了VARCHAR(255),Money变成了DECIMAL(19,4)。 - 约束与索引 (Constraints / Indexes):为了性能优化和数据完整性,这里定义了
PRIMARY KEY、NOT NULL以及外键关系(FK)。 - 具体化:逻辑模型中的抽象字段现在变成了物理表中的具体列。
在这个阶段,架构师需要考虑数据库性能,例如是否需要在 placed_at 字段上建立索引以加快查询速度。图片中展示的表格结构直接对应了可以执行的 CREATE TABLE SQL 语句。
总结:如何选择建模层级?
选择正确的建模层级取决于你的目标受众和决策需求:
- 高层级,少细节:如果你需要向管理层汇报业务蓝图,请使用 概念模型。
- 中间层,重结构:如果你在设计系统架构或编写后端代码,请使用 逻辑模型。
- 低层级,多细节:如果你需要向 DBA 申请数据库资源或生成生产环境脚本,请使用 物理模型。
通过这种分层的建模方法,我们可以确保从业务理解到代码实现的每一步都是清晰、准确且高效的。