
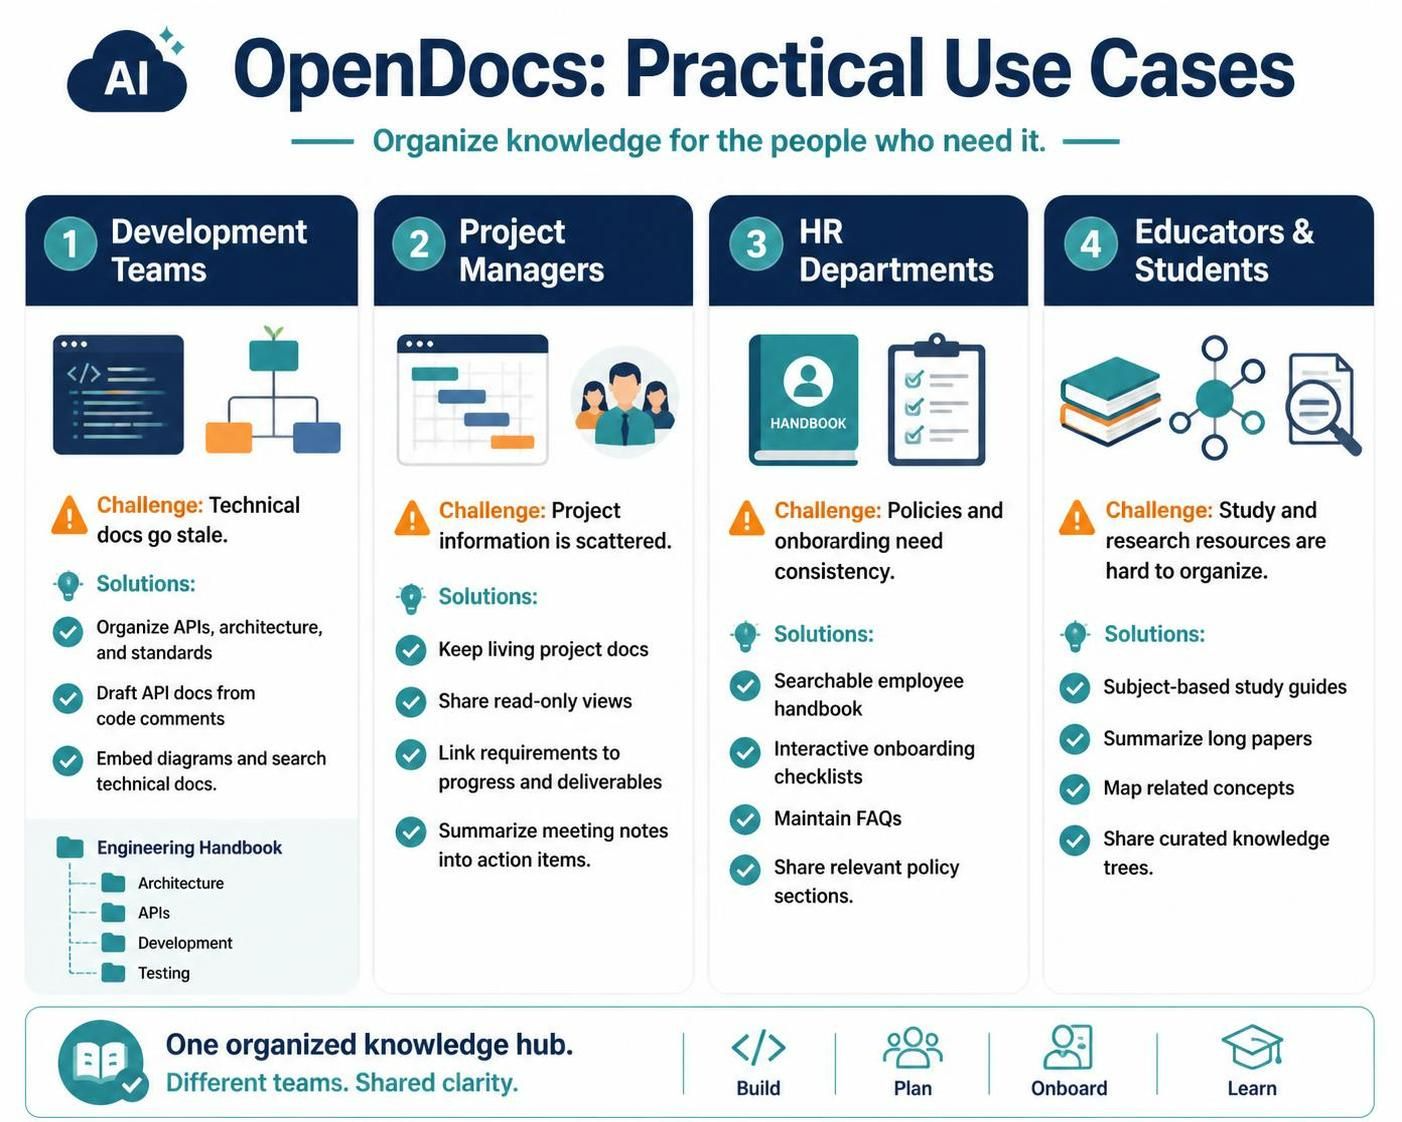
在当今信息爆炸的时代,无论是开发团队、项目经理还是人力资源部门,都面临着知识孤岛与文档过期的严峻挑战。OpenDocs 不仅仅是一个文档管理系统,它实际上是一个基于 AI 驱动的企业级知识图谱构建器。本文将深入解析 OpenDocs 的系统架构,特别是其如何利用结构化数据模型(Hierarchical Data Model)来组织复杂的工程知识库,并展示如何通过 Mermaid 和 PlantUML 等建模语言来实现这一架构的可视化。
一、核心架构:从非结构化到分层知识图谱
OpenDocs 的核心设计理念是将散乱的文档转化为具有明确层级关系的知识图谱。正如开发团队案例中展示的 Engineering Handbook(工程手册),系统采用了树状结构(Tree Structure)来组织内容。这种结构不仅仅是简单的文件夹分类,它实际上定义了信息之间的依赖关系和上下文。
在系统架构层面,我们可以将其建模为以下逻辑层次:
- 根节点 (Root Node):代表整个知识库或组织实体(例如 “Engineering Handbook”)。
- 域节点 (Domain Nodes):代表主要的业务领域,如
Architecture(架构)、APIs(接口)、Development(开发)和Testing(测试)。 - 叶节点 (Leaf Nodes):具体的文档内容,如 “System Overview” 或 “Unit Testing”。
这种分层结构使得 AI 能够理解文档间的语义关联。例如,当 AI 生成 API 文档时,它知道这些文档属于 APIs 域,并且需要引用 Authentication(认证)部分。
架构可视化模型 (Mermaid)
为了更直观地理解这种分层结构,我们可以使用 Mermaid 代码来绘制其内部知识图谱的示意拓扑图:
graph TD
    Root[Engineering Handbook]

    subgraph Architecture [架构域]
        Arch1[System Overview]
        Arch2[Technology Stack]
        Arch3[Decision Records]
    end

    subgraph APIs [接口域]
        API1[REST Endpoints]
        API2[GraphQL Schema]
        API3[Authentication]
    end

    subgraph Dev [开发域]
        Dev1[Setup Guide]
        Dev2[Coding Standards]
        Dev3[Deployment Process]
    end

    subgraph Test [测试域]
        Test1[Unit Testing]
        Test2[Integration Tests]
        Test3[Performance Benchmarks]
    end

    Root --> Architecture
    Root --> APIs
    Root --> Dev
    Root --> Test

    style Root fill:#f9f,stroke:#333,stroke-width:4px
    style Architecture fill:#bbf,stroke:#333
    style APIs fill:#bbf,stroke:#333
    style Dev fill:#bbf,stroke:#333
    style Test fill:#bbf,stroke:#333
二、关键组件:AI 驱动的自动化建模
OpenDocs 架构中最引人注目的特性是其 AI 集成。系统不仅仅是存储文档,它还充当了“自动文档生成器”的角色。以下是三个核心功能的架构解析:
1. 代码即文档 (Code as Documentation)
针对开发团队,OpenDocs 利用静态代码分析(Static Analysis)技术。AI 引擎扫描代码注释(Comments)和定义,自动生成 API 文档。这解决了“文档滞后于代码”的痛点。在架构上,这通常涉及从代码仓库(如 GitHub/GitLab)拉取数据,经过 NLP 处理后,渲染为 Markdown 或 HTML 格式的文档节点。
2. 智能摘要与行动项提取
对于项目经理,系统使用自然语言处理(NLP)技术处理会议录音或文本记录。它将非结构化的会议纪要转化为结构化的数据节点(如 Action Items),并将其链接到具体的项目里程碑。这种技术依赖于序列标注(Sequence Labeling)算法来识别关键实体。
3. 交互式图表生成
系统支持嵌入序列图(Sequence Diagrams)和架构图。这通常通过解析 PlantUML 或 Mermaid 代码来实现。例如,在 Development 模块中,系统可能自动读取 Mermaid 源码,并在渲染时将其转换为可视化的交互图表,帮助团队成员快速理解系统流程。
三、跨部门应用:统一的知识模型
虽然不同部门的需求不同,但 OpenDocs 使用统一的数据模型来适配这些场景:
- HR 部门:利用 权限控制 (Access Control Lists, ACL)。虽然结构是共享的,但 AI 可以根据权限将特定的“政策树”(Policy Trees)暴露给特定用户组,同时隐藏敏感信息。
- 教育与研究:利用 知识地图 (Knowledge Graph Mapping)。系统可以将分散的研究论文通过 AI 提取出的实体(实体如:算法、数据集、作者)连接成网状结构,帮助学生发现跨学科的联系。
系统流程模型 (PlantUML)
为了更好地理解 OpenDocs 如何处理从“输入”到“输出”的文档流,我们可以使用 PlantUML 绘制一个简化的系统处理流程:
@startuml
title OpenDocs Processing Pipeline

skinparam componentStyle rectangle

actor Developer as Dev
actor HR as HR
actor Manager as Mgr

package "OpenDocs Core Engine" {
    component "AI Ingestion Layer" as AI
    component "Knowledge Graph DB" as KG
    component "Rendering Engine" as Render
}

Dev --> AI : Push Code/Docs
HR --> AI : Push Policy Text
Mgr --> AI : Upload Meeting Notes

AI --> KG : Normalize & Index
KG --> Render : Retrieve Context
Render --> Dev : Generate API Docs
Render --> HR : Interactive Handbook
Render --> Mgr : Action Items

note right of AI
  AI 负责提取元数据
  并构建实体关系
end note

note right of KG
  存储结构化数据
  支持复杂查询
end note

@enduml
四、总结与展望
OpenDocs 展示了一种现代知识管理的范式转变:从被动存储转向主动构建。通过结合分层数据结构、AI 自动化和可视化建模工具,它有效地解决了信息孤岛问题。对于技术团队而言,理解这种架构不仅有助于使用工具,更能指导如何编写高质量的文档代码,从而最大化系统的价值。
未来,随着大语言模型(LLM)能力的提升,OpenDocs 这类系统可能会进一步演变为“企业大脑”,能够主动预测开发需求,甚至自动修复过时的架构决策记录。