
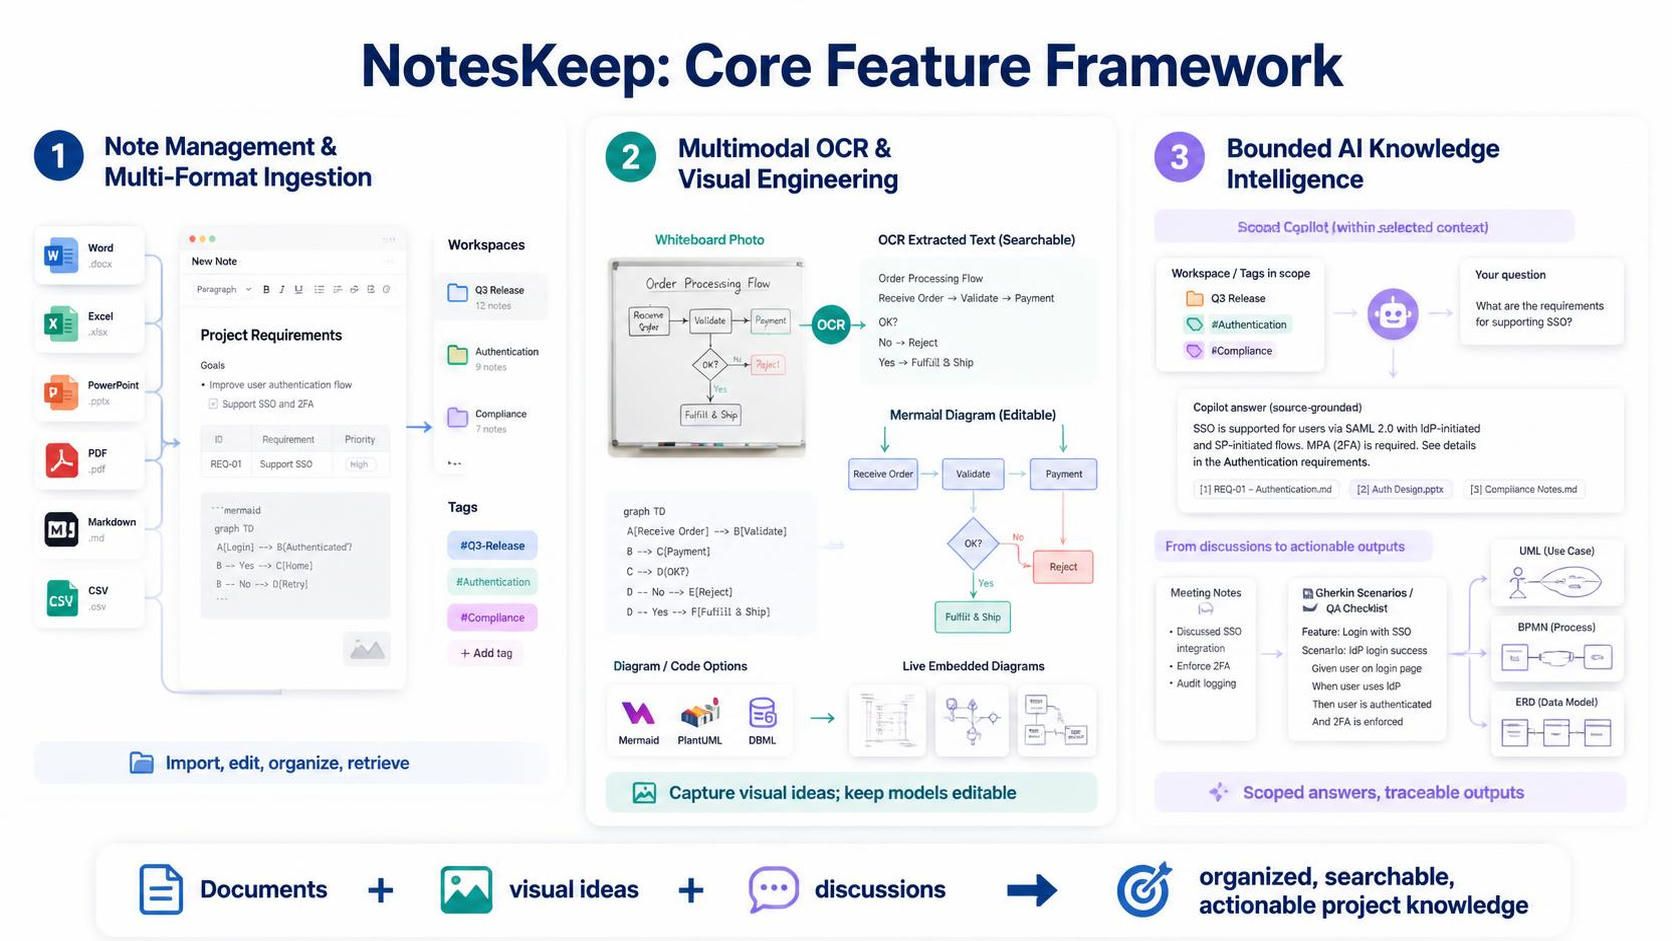
在现代软件工程和产品管理中,将分散的信息(文档、白板草图、会议记录)转化为结构化、可检索且可执行的知识是一项巨大的挑战。NotesKeep 系统通过其核心功能框架,展示了如何构建一个“活的”知识基座。本文将深入剖析该系统的三大核心支柱:多格式文档摄入、多模态视觉工程以及受限AI知识智能,并解释其背后的技术建模逻辑。
1. 统一文档摄入与多维分类体系
系统架构的基石在于能够无缝地吸收异构数据。NotesKeep 不仅仅是一个文本编辑器,它是一个能够解析并转换多种文件格式的通用文档摄入器 (Universal Document Ingestion)。
1.1 异构数据解析与转换
系统支持将 Microsoft Word (.docx)、Excel (.xlsx)、PowerPoint (.pptx)、PDF、Markdown 和 CSV 等文件转换为统一的富文本笔记 (Rich Notes)。这意味着:
- 非破坏性转换: 用户无需手动重写内容,系统自动将静态文件转换为可编辑的富文档。
- 结构化存储: 即使是 Excel 表格或 CSV 数据,也被解析为可操作的表格组件,而非简单的图片。
1.2 多维分类学 (Multi-Dimensional Taxonomy)
为了管理海量信息,系统采用了一种分层分类策略:
- 项目工作区 (Project Workspaces): 这是最高层级的逻辑容器,用于隔离不同项目的上下文。
- 自定义标签矩阵 (Custom Tag Matrices): 在文档之上,用户可以应用多维标签(如
#Q3-Release,#Authentication,#Compliance)。
这种设计允许用户通过交叉引用(Cross-referencing)快速定位信息。例如,你可以同时过滤出“所有关于认证项目的文档”和“所有合规性相关的会议记录”。
2. 多模态视觉工程与代码化模型
这是 NotesKeep 最具创新性的部分。传统的文档工具通常将图表视为静态图片(如 JPG 或 PNG),导致图表无法被编辑、无法版本控制且无法被机器读取。NotesKeep 通过多模态 OCR 与视觉工程解决了这一问题。
2.1 白板转录与视觉提取
系统集成了多模态 OCR 视觉引擎。当用户上传一张白板照片或手绘草图时,AI 不仅提取其中的文字,还识别图形结构(如流程图、ER图)。
- 输入: 白板上手绘的流程图(例如 “Receive Order” -> “Validate” -> “Payment”)。
- 处理: OCR 引擎识别节点和连接关系。
- 输出: 生成可搜索的文本数据,并进一步转换为可编辑的图表代码。
2.2 代码即图表 (Diagram-as-Code)
系统支持将视觉模型转化为代码,这是工程化思维的关键体现。它原生集成了以下语法引擎:
- Mermaid: 用于快速绘制流程图、时序图和类图。
- PlantUML: 用于更复杂的 UML 建模。
- DBML: 用于数据库架构建模。
通过这种转换,图表不再是图片,而是可版本控制的代码。工程师可以直接在笔记中修改代码逻辑,图表会自动重新渲染。此外,系统还支持嵌入活性的 Web 图表(如 Excalidraw)。
2.3 核心建模逻辑示例
基于提供的图片场景,系统如何将白板草图转化为 Mermaid 代码逻辑如下:
graph TD
    A[Receive Order] --> B[Validate]
    B --> C{Payment}
    C -->|Yes| D[OK?]
    C -->|No| E[Reject]
    D -->|Yes| F[Fulfill & Ship]
    D -->|No| E
此逻辑展示了从原始草图到结构化流程图的映射过程。系统能够识别菱形决策点(如 “OK?”)和并行路径,并将其固化为标准化的流程图符号。
3. 受限 AI 知识智能 (Bounded AI Knowledge Intelligence)
在构建知识系统时,最大的痛点是 AI 的“幻觉”问题。NotesKeep 通过受限上下文 (Scoped Context)和检索增强生成 (RAG)技术来确保答案的准确性。
3.1 空间受限的 AI 助手
AI 助手不是基于全网知识,而是被严格限制在用户选定的工作区或标签上下文内。
- 机制: 当用户提问时,系统仅在选定的标签(如
#Authentication)范围内检索信息。 - 优势: 这消除了无关信息干扰,确保生成的答案具有绝对的内联引用(Inline Citations)。
3.2 需求合成与自动化
系统展示了从“讨论”到“可执行代码”的自动化流水线:
- 输入: 会议记录或原始描述性文本。
- AI 合成: 将非结构化文本转化为Gherkin 场景(自动化测试用例)和BPMN(业务流程)。
- 模型生成: 自动创建ERD(实体关系图)和 UML 用例图。
例如,AI 可以分析会议记录中的“SSO 登录”需求,直接生成对应的 UML 用例图和 BPMN 流程图,甚至生成测试脚本。
3.3 核心流程逻辑示例
从需求到测试用例的转换逻辑(Gherkin)如下:
Feature: Login with SSO
  Scenario: IdP login success
    Given user is on login page
    When user uses IdP
    Then user is authenticated
    And 2FA is enforced
总结
NotesKeep 的架构展示了一个完整的闭环:摄入 (Ingestion) 任意格式的文档,转化 (Engineering) 视觉草图为可编辑代码,并利用智能 (Intelligence) 将讨论转化为可执行的测试和模型。这种“文档 + 代码 + AI”的混合模式,代表了下一代工程知识管理的方向。