
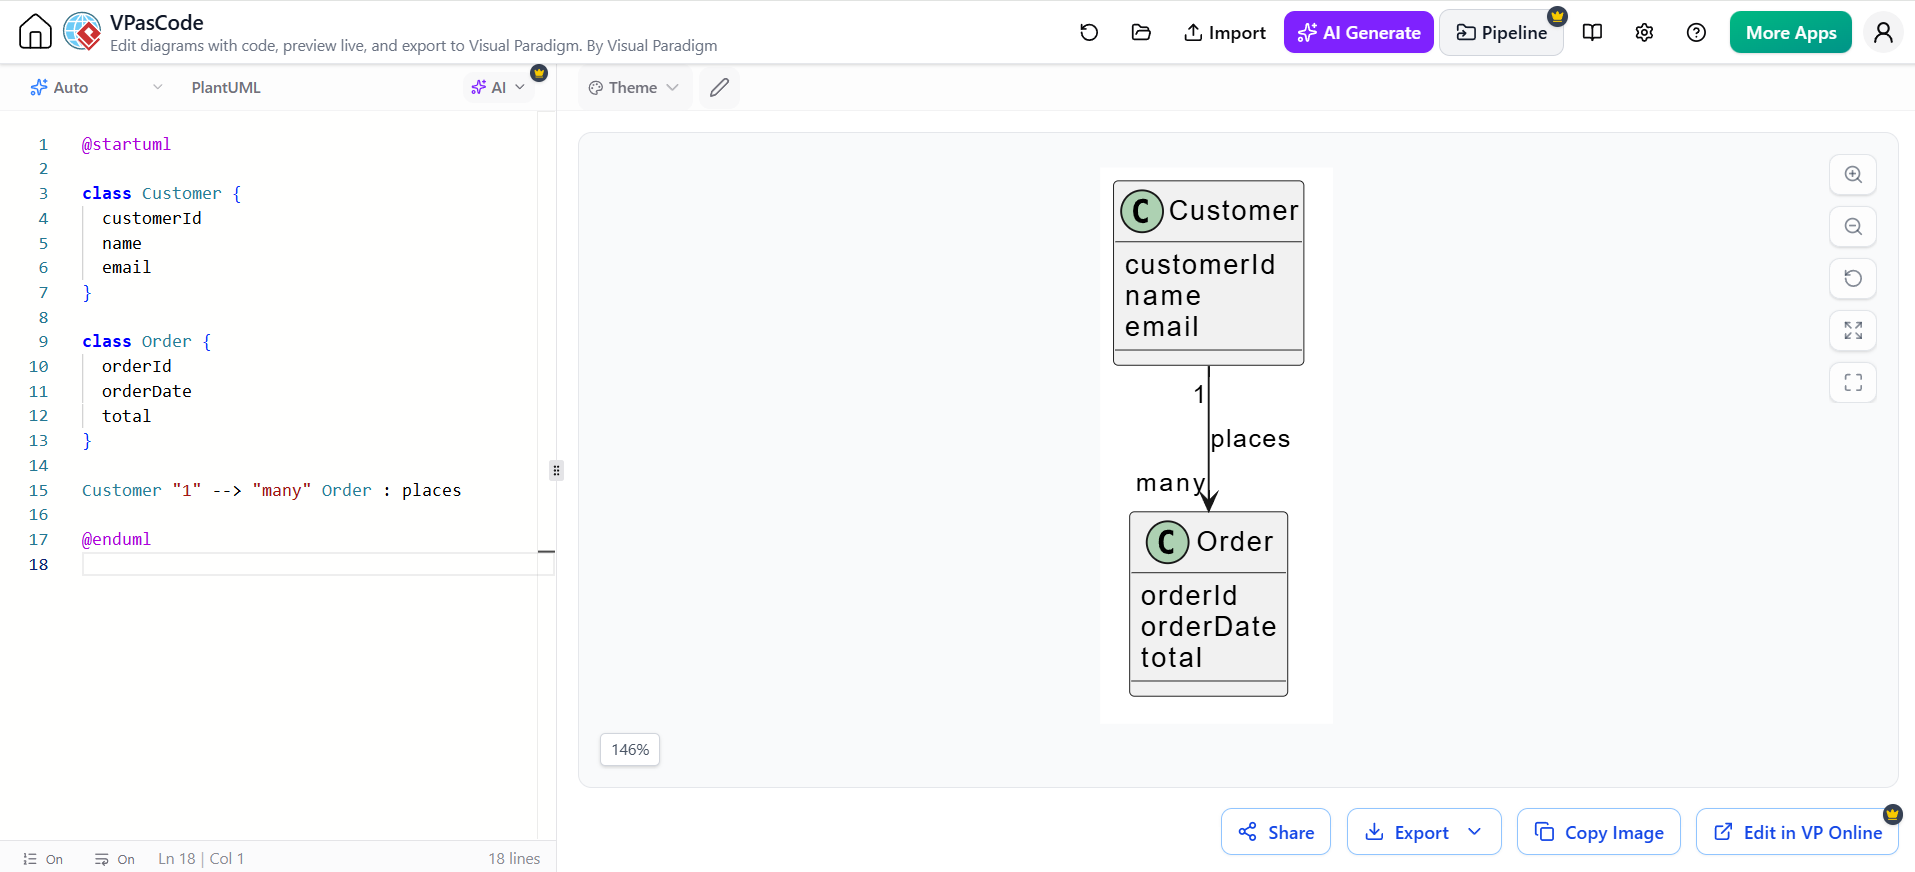
在现代软件工程与系统架构设计中,Visual Paradigm 推出的 VPasCode 工具代表了建模方式的一次范式转移。传统的建模工具(如标准 Visual Paradigm UML)通常采用“所见即所得”的图形化界面,用户直接在画布上拖拽元素。然而,VPasCode 引入了“以代码为中心”的建模理念,特别是其核心支持的 PlantUML 语法。本文将深入解析这一架构如何运作,并详细讲解图中展示的“客户与订单”类图示例,帮助您理解从文本逻辑到视觉图表的完整转换过程。
一、核心架构:图形化 vs. 代码化
要深入理解 VPasCode,首先必须厘清其与传统 UML 工具的根本区别:
- 传统 UML (Visual Paradigm UML): 核心工作区是图形画布。用户通过鼠标点击、拖拽来放置类、接口和连接线。这种模式直观,但在处理复杂系统时,容易出现视觉混乱,且难以版本控制。
- VPasCode (Diagram-as-Code): 核心工作区是文本编辑器。图表被视为“渲染结果”,而非“原始数据”。用户编写代码(定义),系统负责渲染(呈现)。这种模式强调逻辑的严密性,代码即文档,且便于通过 Git 进行版本管理。
在 VPasCode 界面中,这种二元性体现得淋漓尽致:左侧是代码编辑区,右侧是实时渲染的预览区。当您修改左侧的文本时,右侧的图表会立即重新计算布局。
二、VPasCode 系统架构详解
VPasCode 并非简单的文本编辑器,它是一个完整的建模引擎。其内部架构主要包含三个关键组件:
- 解析器 (Parser): 负责读取左侧的文本输入。它识别特定的语法结构(如
@startuml开始标记,class类定义),并将其解析为抽象语法树(AST)。 - 渲染引擎 (Rendering Engine): 将解析后的逻辑数据转换为图形元素。它负责计算类的大小、属性的排列方式以及连线的方向。
- 布局算法 (Layout Algorithm): 这是 VPasCode 的“大脑”。它自动决定对象在画布上的位置(例如,将
Customer放在上方,Order放在下方),以确保图表的可读性。
三、实战解析:构建客户订单类图
让我们通过图中展示的具体案例,逐步拆解代码如何转化为图表。该示例展示了一个经典的“一对多”业务关系。
1. 声明与结束标记
每一个完整的 PlantUML 图表都需要明确的开始和结束指令。这告诉解析器当前的上下文是 UML 类图。
@startuml
...
@enduml
2. 定义类结构 (Class Definition)
在代码中,我们使用 class 关键字来定义对象。类的名称(如 Customer)通常会自动转换为可视化的标题。
class Customer {
  customerId
  name
  email
}

class Order {
  orderId
  orderDate
  total
}
在上述代码中,大括号内的每一行代表一个属性(Attribute)。在右侧的预览中,这些属性会自动堆叠显示在类名的下方。
3. 定义关系 (Relationships)
这是系统架构中最关键的部分,描述了对象之间的交互。图中的关系定义如下:
Customer "1" --> "many" Order : places
让我们拆解这条语句的语义:
- 源对象:
Customer(客户)。 - 目标对象:
Order(订单)。 - 连接符:
-->表示实线箭头,通常代表关联关系(Association)。 - 多重性 (Cardinality):
"1"和"many"定义了基数约束。这意味着一个客户可以下“多”个订单,而一个订单由一个客户创建。 - 标签 (Label):
places是关系的语义描述,解释了“客户”与“订单”之间是如何连接的(客户“下”订单)。
VPasCode 的渲染引擎读取这行代码后,会自动绘制一条直线,从 Customer 指向 Order,并在箭头附近标注 “1” 和 “many”,同时在线的中间或上方显示 “places”。
四、总结
通过 VPasCode,开发者不再需要花费大量时间调整图形的位置或绘制连接线。只需关注逻辑定义:定义类、定义属性、定义关系。这种“文本即模型”的架构极大地提高了架构设计的效率和准确性,是现代化系统建模的重要工具。