
在当今快节奏的工作环境中,信息是任何成功组织的命脉。然而,这一宝贵资产往往分散在无数的文档、无尽的聊天线程以及团队成员的个人记忆中。挑战不仅仅在于存储信息,更在于使其变得易于访问、组织有序且可操作。OpenDocs 正是 Visual Paradigm 推出的革命性 AI 驱动知识管理平台,旨在将这种混乱转化为一个单一的、智能的枢纽。
本文将以技术视角深入剖析 OpenDocs 的系统架构与数据流向,解释它是如何将分散的“碎片化知识”转化为“有组织知识”的。我们将通过图解分析其核心处理逻辑,并探讨其背后的建模概念。
系统架构概览:从混沌到有序
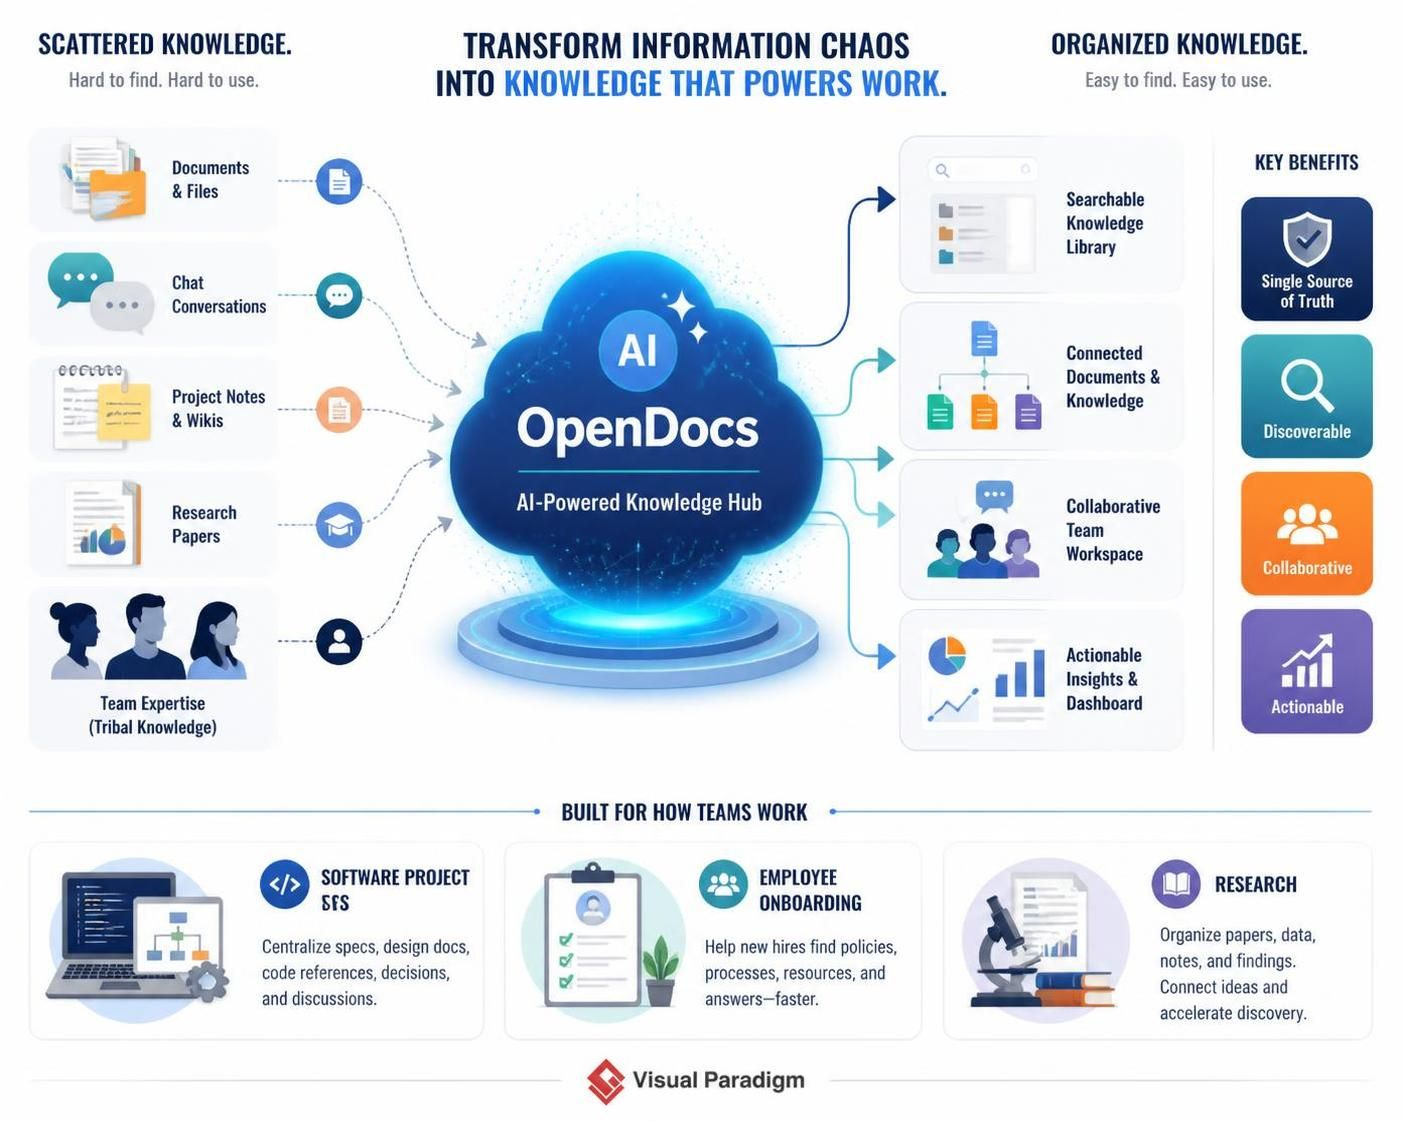
根据提供的系统架构图,OpenDocs 的核心功能可以被理解为一个强大的 ETL(Extract, Transform, Load)过程,但它是针对非结构化数据(如文本、对话、笔记)进行的。整个架构可以分为三个主要阶段:输入源(Scattered Knowledge)、核心处理引擎(AI-Powered Knowledge Hub)以及输出价值(Organized Knowledge)。
1. 输入层:分散的知识源
系统的左侧展示了“分散的知识”,这是企业中最常见但也最难管理的状态。OpenDocs 通过多种接口捕获以下四类关键数据源:
- 文档与文件 (Documents & Files): 包括 PDF、Word 文档、电子表格等静态文件。这是企业知识库的基础。
- 聊天对话 (Chat Conversations): 来自 Slack、Teams 或内部 IM 工具的即时通讯记录。这些通常包含隐性的决策过程和临时的技术讨论。
- 项目笔记与维基 (Project Notes & Wikis): 分散在 Jira、Confluence 或 Trello 中的任务描述和协作记录。
- 研究论文与专家经验 (Research Papers & Team Expertise): 包括外部的行业报告以及内部员工的“部落知识”(Tribal Knowledge),即那些存在于员工脑海中但未文档化的经验。
2. 核心处理层:AI 驱动的知识中枢
位于架构中心的是 OpenDocs AI-Powered Knowledge Hub。这是整个系统的“大脑”。在这个阶段,系统执行以下关键操作:
- 数据聚合 (Aggregation): 将上述异构数据源统一接入。
- 语义理解 (Semantic Understanding): 利用 AI 模型(如 NLP 或 LLM)解析非结构化文本,提取关键实体、概念和上下文关系。
- 知识图谱构建 (Knowledge Graph Construction): 将孤立的文档和对话连接起来,形成相互关联的知识网络。例如,将某个聊天中的技术决策与对应的代码文档或设计图纸自动关联。
3. 输出层:有组织知识
经过 AI 处理后,系统右侧展示了“有组织知识”的形态,即系统交付给用户的最终价值:
- 可搜索的知识库 (Searchable Knowledge Library): 不再是简单的关键词匹配,而是基于语义的智能搜索。
- 关联文档与知识 (Connected Documents & Knowledge): 自动生成的知识图谱,展示文档之间的引用和依赖关系。
- 协作团队空间 (Collaborative Team Workspace): 一个集成的环境,支持多人协同编辑和讨论。
- 可操作的洞察与仪表盘 (Actionable Insights & Dashboard): 通过数据分析展示团队的知识状态、项目进度和关键指标。
技术实现与建模逻辑
在 Visual Paradigm 的建模体系中,我们可以将 OpenDocs 视为一个复杂的 上下文图 (Context Diagram) 或 系统架构图 (System Architecture Diagram)。这种模型清晰地定义了系统的边界以及它与外部实体(如用户、外部文档系统)的交互。
以下是描述该数据流逻辑的伪代码表示,展示了数据如何在系统中流动:
graph TD
    subgraph External_Sources [分散的知识源]
        Doc[文档与文件]
        Chat[聊天对话]
        Wiki[项目笔记]
        Expert[专家经验]
    end

    subgraph OpenDocs_Core [OpenDocs AI 中枢]
        Ingest[数据摄入管道]
        AI_Process[AI 语义分析与清洗]
        Graph_DB[知识图谱存储]
    end

    subgraph User_Interface [有组织知识]
        Search[可搜索库]
        Connect[关联文档]
        Dashboard[仪表盘]
    end

    Doc --> Ingest
    Chat --> Ingest
    Wiki --> Ingest
    Expert --> Ingest

    Ingest --> AI_Process
    AI_Process --> Graph_DB

    Graph_DB --> Search
    Graph_DB --> Connect
    Graph_DB --> Dashboard

    style OpenDocs_Core fill:#e1f5fe,stroke:#01579b,stroke-width:2px
    style External_Sources fill:#fff3e0,stroke:#e65100,stroke-width:2px
通过这种架构,OpenDocs 解决了传统文档管理系统(DMS)的痛点:传统 DMS 只是存储文件,而 OpenDocs 通过 AI 理解内容并建立连接。
应用场景与价值
OpenDocs 不仅仅是一个工具,它被设计为适应团队实际工作流的平台。根据图示,它在三个主要场景中发挥着关键作用:
- 软件项目管理 (Software Projects): 集中管理需求规格说明书、设计文档、代码参考和决策记录。这有助于减少“信息孤岛”,确保开发人员能随时找到最新的设计规范。
- 员工入职培训 (Employee Onboarding): 帮助新员工快速找到政策、流程和资源。AI 驱动的问答功能可以即时回答新员工关于公司流程的常见问题,缩短培训周期。
- 研究与开发 (Research): 组织论文、数据、笔记和发现。通过连接不同的想法和发现,加速知识发现的过程,促进创新。
总结
OpenDocs 代表了知识管理领域的一次范式转变。它不再是被动的文件存储库,而是主动的知识引擎。通过将分散的文档、对话和专家经验整合到一个统一的 AI 驱动平台中,OpenDocs 实现了“单一事实来源”(Single Source of Truth)的目标。对于任何希望提升团队协作效率、加速知识流转的组织来说,这种架构都是极具价值的解决方案。