
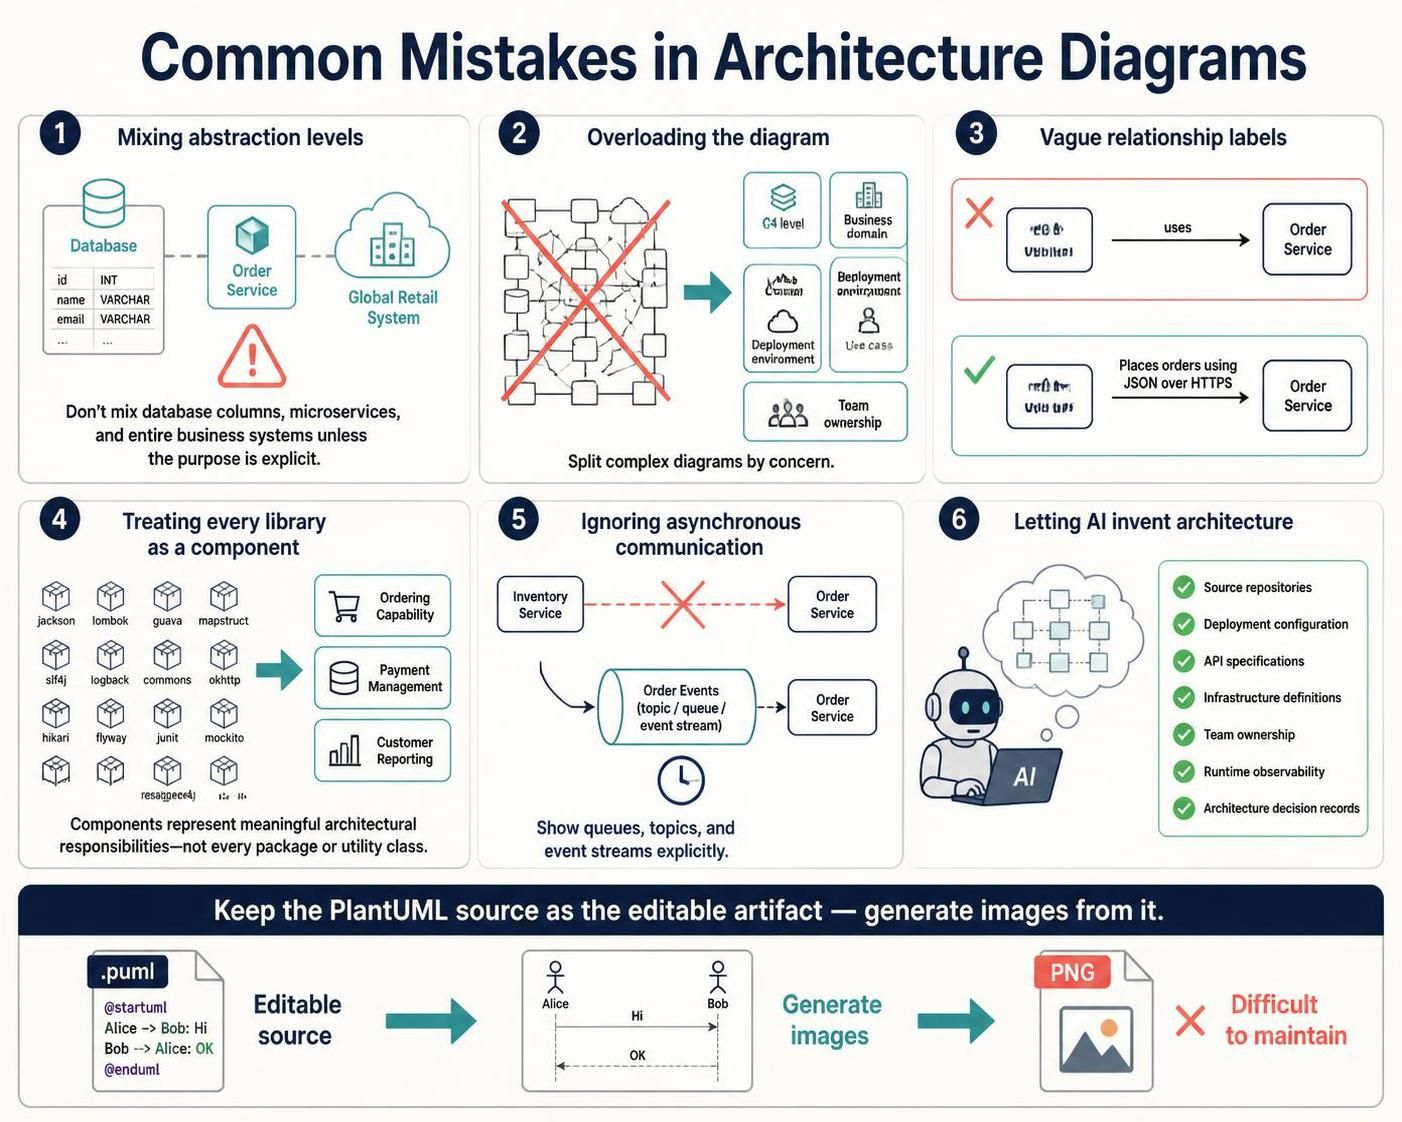
在绘制系统架构时,无论是使用传统的UML工具,还是现代的可代码化绘图工具(如 PlantUML 或 VPasCode),架构师最常犯的错误往往不在于技术细节的缺失,而在于建模方法论的误用。一张优秀的架构图应当清晰地传达系统的边界、组件职责以及数据流向,而不是成为一堆杂乱符号的堆砌。
本文将深入解析系统架构设计中常见的六大陷阱,并结合 C4模型 和 Visual Paradigm 的建模规范,为您提供清晰的修正方案。
1. 混淆抽象层级 (Mixing Abstraction Levels)
这是新手架构师最常犯的错误。在一张图中,同时展示数据库的底层字段(如 VARCHAR)、微服务(Order Service)以及整个业务系统(Global Retail System),会导致读者的认知负荷过重。
在 C4模型 中,每一个层级都有明确的定义:
- Context (系统上下文): 描述系统与外部用户的关系。
- Container (容器): 描述系统内部的部署单元,如Web应用、API服务。
- Component (组件): 描述容器内部的功能模块。
- Code (代码): 描述具体的类或函数(通常不需要在架构图中展示)。
如果您正在使用 VPasCode 进行建模,请确保您的图表专注于单一层级。例如,在绘制 Container 图时,数据库应作为一个整体容器出现,而不应展开显示其内部的 id 或 name 列。
修正策略
不要试图用一张图解释一切。如果您的系统很复杂,请根据 VPasCode 的上下文视图(Context View)或容器视图(Container View)进行拆分,确保每一张图都有其明确的目的。
2. 过度加载图表 (Overloading the Diagram)
当一张架构图变得难以阅读时,通常是因为试图在一个视图中包含过多的信息。这不仅降低了可读性,还掩盖了关键的业务逻辑。
解决“图表过载”的最佳实践是进行分面视图(Faceted Views)设计。您可以按照以下维度对图表进行拆分:
- C4 层级: 分别为系统上下文、容器、组件绘图。
- 业务领域: 按领域驱动设计(DDD)拆分,如“订单域”与“库存域”分开。
- 部署环境: 区分生产环境与开发环境。
- 团队所有权: 展示不同团队负责的微服务边界。
示例:拆分视图
与其画一张包含所有微服务的“大杂烩”图,不如创建两张图:一张侧重于“用户交互流程”,另一张侧重于“后台数据处理流程”。
3. 模糊的关系标签 (Vague Relationship Labels)
在架构图中,连线上的标签至关重要。仅仅写一个“使用(uses)”或“连接(connects)”是远远不够的,因为它没有传达技术细节。
错误示例:
[Order Service] → [Global System] (标签:uses)
正确示例:
应该明确描述通信协议、数据格式和接口类型。这有助于开发人员快速理解集成的方式。
[Order Service] → [Global System] (标签:Places orders using JSON over HTTPS)
在 VPasCode 中,您可以使用 label 属性来丰富关系描述:
@startuml
skinparam componentStyle rectangle
actor User
database Database
User --> "Places orders using JSON over HTTPS" : Order Service
@enduml
4. 将每个库都视为组件 (Treating Every Library as a Component)
架构图的目的是展示系统的宏观结构,而不是代码目录结构。将所有的第三方库(如 jackson, logback, guava, hibernate)都画成独立的组件,会让架构图变得极其臃肿且无意义。
原则: C4 组件应该代表有意义的架构职责(如“支付管理”、“订单处理”),而不是每一个包(Package)或工具类(Utility Class)。
正确的做法是将这些库视为组件的依赖项(Dependencies),或者在“容器”视图中将其作为背景信息提及,而不是作为一级组件。
对比分析
| 错误做法 (代码视角) | 正确做法 (架构视角) |
|---|---|
|
|
5. 忽略异步通信 (Ignoring Asynchronous Communication)
在现代分布式架构中,同步调用(HTTP/RPC)只是冰山一角。消息队列(Queues)、主题(Topics)和事件流(Event Streams)是系统解耦的关键。
如果在图中忽略了这些异步机制,读者可能会错误地假设所有交互都是实时的。这会导致对系统性能、可靠性和数据一致性的误判。
最佳实践: 必须显式地画出消息中间件(如 Kafka, RabbitMQ)以及相关的主题或队列。
@startuml
container_asynchronous "Order Events" (Topic / Queue / Event Stream)
participant "Order Service"
participant "Inventory Service"

Order Service ->> Inventory Service : Synchronous API
Order Service --> "Publishes" "Order Events" : Asynchronous
"Order Events" --> "Inventory Service" : Consumes
@enduml
6. 让 AI 凭空捏造架构 (Letting AI Invent Architecture)
虽然 AI 可以生成看似合理的架构图,但AI 无法访问您的真实代码库、部署配置或基础设施定义。AI 生成的架构往往基于通用模式,可能包含不存在的服务、虚构的协议或错误的网络拓扑。
验证清单: 在使用 AI 辅助生成或审查架构时,必须对照以下真实数据进行验证:
- 源代码仓库 (Source repositories): 实际存在的服务和模块。
- 部署配置 (Deployment configuration): Kubernetes YAML, Docker Compose, Terraform 脚本。
- API 规范 (API specifications): Swagger/OpenAPI 文档。
- 基础设施定义 (Infrastructure definitions): VPC, Load Balancer, Database 配置。
- 运行时可观测性 (Runtime observability): 实际的监控数据和日志。
- 架构决策记录 (Architecture decision records – ADRs): 团队的决策历史。
保持可维护性:使用源码而非图片
最后,也是最重要的一点:不要只保存导出的 PNG 图片。图片是静态的,难以维护,且无法进行版本控制。
始终将 PlantUML 或 VPasCode 的源代码作为唯一的可编辑工件(Editable Artifact)。通过 .puml 文件,您可以:
- 在 Git 中追踪架构的变更历史。
- 在 CI/CD 流水线中自动生成最新的架构图。
- 与其他开发者协作修改架构细节。
@startuml
' Editable Source
actor Alice
actor Bob
Alice -> Bob: Hi
Bob --> Alice: OK
@enduml
记住,图片是结果,源码才是过程。 只有维护好源码,您的架构文档才能随着系统演进而保持鲜活。