
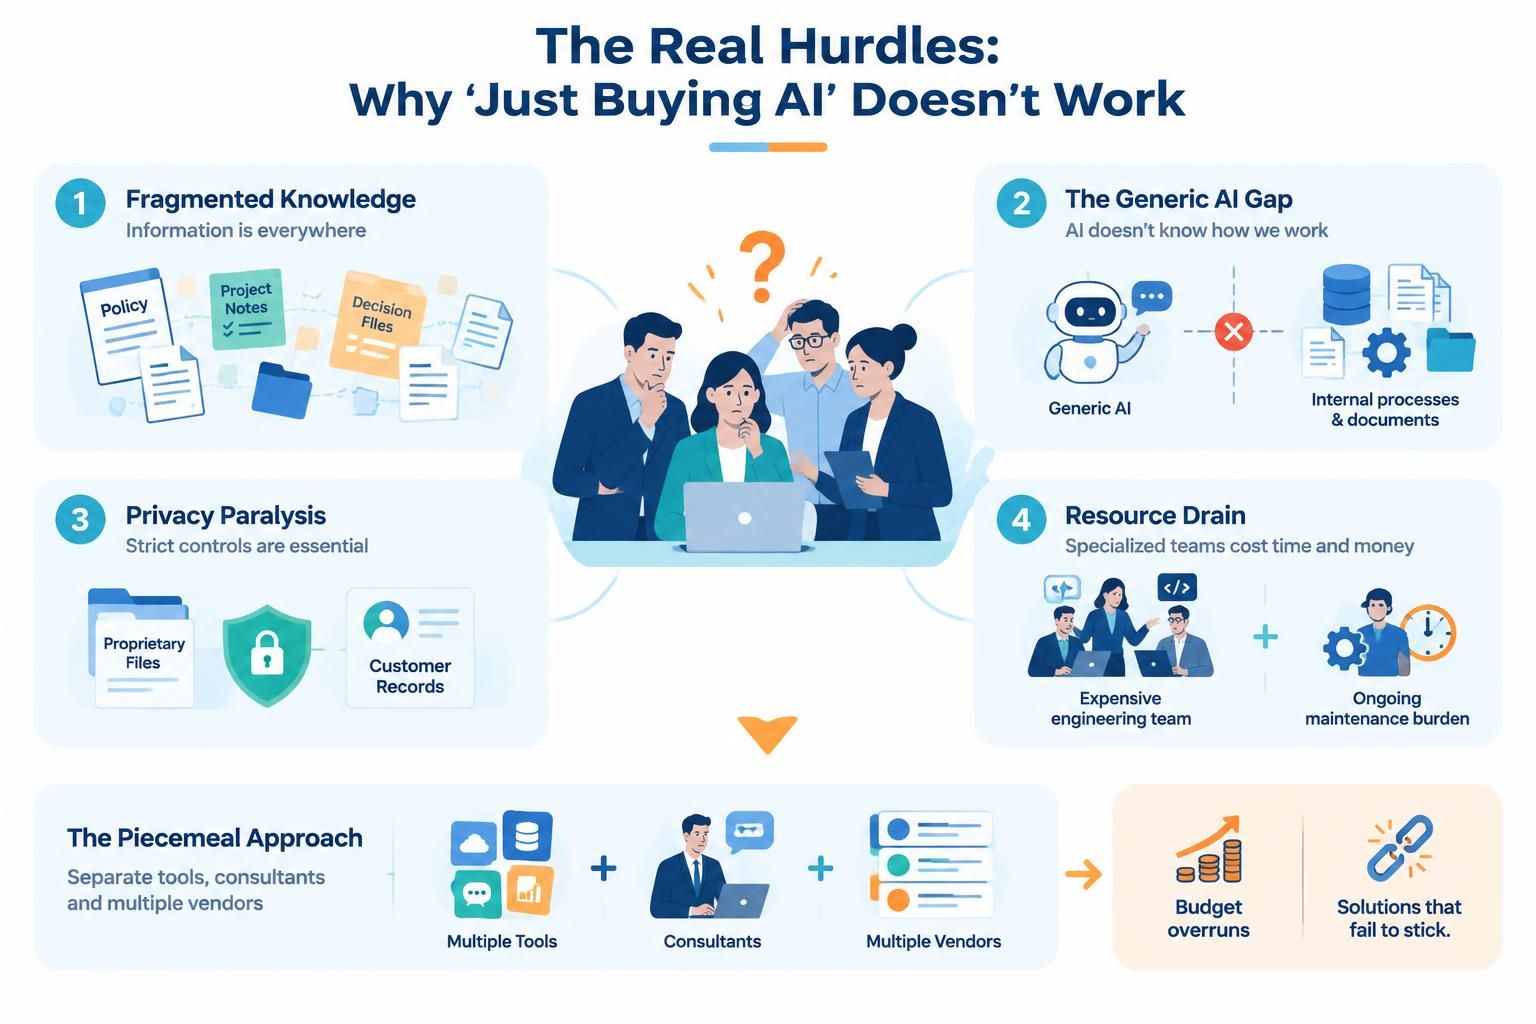
在数字化转型的浪潮中,许多企业面临着严峻的挑战。正如我们在背景材料中所看到的,仅仅“购买AI”并不能解决所有问题。相反,企业往往陷入“碎片化知识”、“通用AI的局限”、“隐私恐慌”以及“资源枯竭”的泥潭中。要解决这些痛点,我们需要从系统架构的高度出发,不再依赖零散的工具拼凑,而是采用Visual Paradigm AI Ecosystem中的Self Host AI Total Solution(自托管AI总解决方案)概念。
本文将作为您的技术向导,深入解析如何通过C4模型中的系统上下文图(Context Diagram)来描绘这一架构,并探讨其背后的技术逻辑与业务价值。
从痛点到架构:理解系统上下文
在构建企业级AI系统之前,我们必须明确系统的边界。Visual Paradigm的VPasCode(基于文本的建模语言)允许我们快速定义系统与其外部交互者的关系。对于“自托管AI总解决方案”而言,其核心目标是连接企业内部的数据孤岛与现代化的AI能力。
让我们通过C4模型的视角,将背景中提到的四个核心痛点转化为架构需求:
- 碎片化知识(Fragmented Knowledge): 系统必须能够聚合分散的Policy(策略)、Project Notes(项目笔记)和Decision Files(决策文件)。在架构图中,这意味着数据源(Data Source)不再是孤立的,而是汇聚到统一的中间件层。
- 通用AI缺口(The Generic AI Gap): 外部通用的AI模型(Generic AI)无法理解内部流程。架构必须包含一个Knowledge Base(知识库)或Vector Database(向量数据库),用于存储企业的特定上下文。
- 隐私瘫痪(Privacy Paralysis): 涉及Proprietary Files(专有文件)和Customer Records(客户记录)的数据不能随意流出。这要求架构必须是Self-Hosted(自托管)的,数据驻留在企业内网。
- 资源枯竭(Resource Drain): 企业不愿维护庞大的工程团队。因此,架构设计应强调“开箱即用”的集成能力,减少定制开发和维护成本。
架构建模:使用VPasCode绘制系统上下文图
为了清晰地向利益相关者展示这一解决方案,我们可以使用VPasCode编写代码来生成System Context Diagram。这种图表能直观地展示企业(系统)与外部角色(员工、数据源、AI引擎)之间的交互。
以下是一个标准的VPasCode代码示例,展示了如何构建这个自托管AI总解决方案的架构蓝图:
// Enterprise AI Ecosystem Context Diagram
// 定义系统边界
system("Self-Hosted AI Total Solution", "Enterprise AI Core") {

    // 定义内部组件
    container("Knowledge Base", "Vector DB", "Stores internal policies, notes, decisions")
    container("AI Inference Engine", "LLM Runtime", "Local processing of AI models")
    container("Security Gateway", "Firewall/Access Control", "Manages privacy and data access")

    // 定义外部角色
    person("Employees", "Internal Staff", "Accessing AI for work")
    person("Admins", "IT/Security Team", "Managing the environment")
    database("Legacy Systems", "SQL/Document Stores", "Source of fragmented knowledge")
    external_system("External API", "Public Web Services", "Optional external data lookup")

    // 定义连接关系
    bi_rel("Employees", "AI Inference Engine", "Queries & Updates")
    rel("AI Inference Engine", "Knowledge Base", "Retrieves context")
    rel("Knowledge Base", "Legacy Systems", "Ingests data from")
    rel("Security Gateway", "Employees", "Enforces Privacy Controls")
    rel("Security Gateway", "AI Inference Engine", "Filters Sensitive Data")
    rel("Admins", "Security Gateway", "Configures Policies")
}
通过这段代码,我们构建了一个清晰的逻辑视图。企业员工(Employees)直接与推理引擎(Inference Engine)交互,而引擎则从向量数据库(Knowledge Base)中检索知识,这些数据源自遗留系统(Legacy Systems)。最重要的是,安全网关(Security Gateway)被放置在关键位置,确保专有文件和客户记录不会泄露。
技术深度解析:如何解决“碎片化”与“隐私”
上述架构不仅仅是图形的堆砌,它代表了一系列复杂的技术决策。
1. 向量检索与RAG架构
针对“碎片化知识”,企业通常采用RAG (Retrieval-Augmented Generation) 架构。Visual Paradigm的AI生态系统支持将非结构化数据(如PDF策略、Word文档)转化为向量嵌入(Vector Embeddings),存入向量数据库。当员工提问时,系统首先检索相关片段,再将其作为上下文发送给本地大语言模型。这完美解决了“AI不知道我们如何工作”的问题。
2. 数据驻留与私有化部署
针对“隐私瘫痪”,自托管解决方案的核心在于Data Residency(数据驻留)。所有的数据(包括客户记录)都在企业内部的AWS VPC或私有云环境中流转。代码层面上的SQL查询和BPMN流程都在内部闭环运行,无需将敏感数据发送到公有云AI服务。
3. 统一的管理平面
为了应对“资源枯竭”,自托管总解决方案通常提供一个统一的管理平面(Management Plane)。通过UML或ERD设计的数据库模型确保了数据的一致性,而标准化的API接口减少了与多个供应商(Multiple Vendors)对接的复杂性。
总结:从“拼凑”到“集成”的转变
背景中提到的“拼凑方法(The Piecemeal Approach)”——购买多个工具、雇佣顾问、管理多个供应商——往往是导致预算超支和解决方案失效的根源。通过采用Visual Paradigm AI Ecosystem提供的Self Host AI Total Solution,企业可以将这些分散的元素整合为一个有机的整体。
这不仅是一个技术升级,更是一次业务模式的变革。它通过清晰的System Context Diagram明确了数据流向和安全边界,让企业能够在保护隐私的前提下,充分利用内部知识资产,实现真正的智能化转型。
现在,您已经有了构建这一架构的蓝图。下一步,就是利用Visual Paradigm的工具集,将这一概念转化为可执行的企业级系统。