
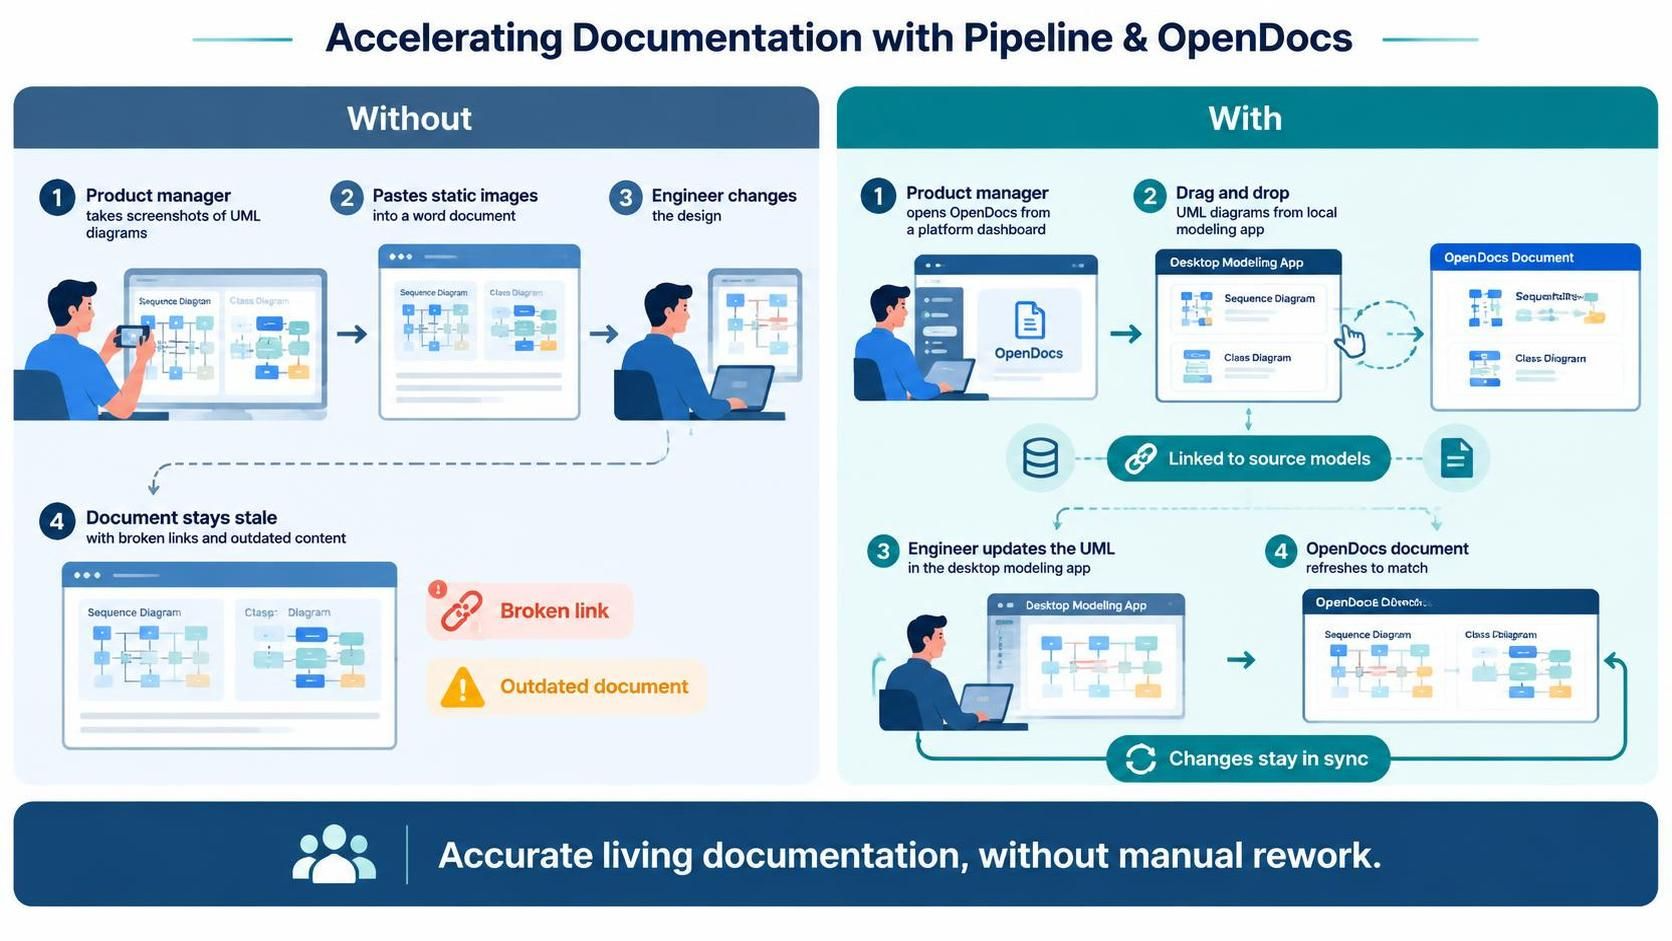
在现代软件开发生命周期中,技术文档的维护往往是一个被低估的痛点。对于产品经理(PM)而言,如何确保技术规格说明书中的 UML 图表与工程团队的最新设计保持同步,是一个巨大的挑战。传统的“截图 + 粘贴”工作流不仅效率低下,而且极易导致文档过时。本文将深入解析 Visual Paradigm Unified Platform 如何通过 Pipeline 和 OpenDocs 的功能集成,实现“单一数据源(Single Source of Truth)”的文档自动化。
一、传统工作流的痛点分析
在没有统一平台支持的协作模式下,文档编制通常遵循以下流程,这种流程存在显著的“数据孤岛”效应:
- 静态快照: 产品经理在编写文档时,直接从 Desktop Modeling App 中截取 UML 序列图或类图的图片。
- 脱离源模型: 这些图片被粘贴到 Word 或其他文档编辑器中,它们与底层的元数据(Metadata)和模型结构完全断开。
- 维护灾难: 当工程师修改了代码或调整了类结构(Class Structure)时,文档中的图片不会自动更新。PM 必须手动重新截图并替换,这导致了“更新疲劳”,最终文档往往停留在旧版本,失去了指导意义。
二、Unified Platform 的核心架构:Pipeline 与 OpenDocs
Visual Paradigm 的 Unified Platform 通过 Pipeline(管道)和 OpenDocs(开放文档)构建了动态文档生态系统。这一架构的核心在于双向链接(Linked References)。
1. OpenDocs 文档环境
OpenDocs 是一个基于 Web 的文档编写器,它不仅仅是文本编辑器,更是一个支持Live Preview(实时预览)的画布。它允许用户直接嵌入模型元素,而非静态图片。
2. Pipeline 连接机制
Pipeline 充当了本地建模工具(Desktop)与云端文档(OpenDocs)之间的数据桥梁。它通过建立Source Model(源模型)与Document Artifact(文档组件)之间的引用关系,确保任何一方的变更都能触发数据流的同步。
三、实战演练:从截图到动态链接
让我们通过一个具体的场景,演示如何利用 Unified Platform 重塑文档流程。
步骤 1:打开 OpenDocs 并加载文档
产品经理登录 Unified Platform Dashboard,打开 OpenDocs 并加载现有的技术规格文档。此时,文档区域是空白的或包含基础的文本说明。
步骤 2:拖拽模型元素(Drag & Drop)
这是最关键的一步。PM 无需截图,而是直接打开本地工程文件(.vpix 或 .vpxml),选中包含 UML Sequence Diagram(序列图)和 Class Diagram(类图)的窗口。
PM 直接将这两个图表从桌面应用拖拽到 OpenDocs 的 Web 界面中。系统会自动创建一个指向本地模型的链接(Link),而不是生成一张图片文件。
步骤 3:建立数据关联
在 OpenDocs 中,您会看到图表下方出现了一个特殊的状态图标,表明该图表已 Linked to Source Models(链接到源模型)。此时,文档中的图表实际上是实时渲染的模型视图。
步骤 4:触发自动同步
当工程师在 Desktop Modeling App 中修改了某个类的属性或调整了时序图中的消息流时,只需保存模型。
由于 Pipeline 的存在,OpenDocs 文档在下次打开或刷新时,会自动检测到模型变更,并立即重新渲染图表。PM 无需进行任何手动操作,文档即保持最新。
四、技术优势总结
- 消除“过时”风险: 文档不再是静态档案,而是随着模型演进的“活文档”。
- 提升协作效率: 减少了 PM 与开发团队之间反复沟通“图不对版”的时间成本。
- 单一维护入口: 所有的图表维护都在 Desktop 端完成,Web 端仅作为展示窗口,保证了数据的完整性。
五、结语
通过 Visual Paradigm Unified Platform,我们将文档编制从“手动维护”转变为“自动同步”。这种架构不仅解决了文档过时的行业难题,更实现了从需求分析到设计落地的全链路数据一致性。对于追求敏捷开发和高文档质量的企业而言,Pipeline 与 OpenDocs 的组合是不可或缺的工具。