
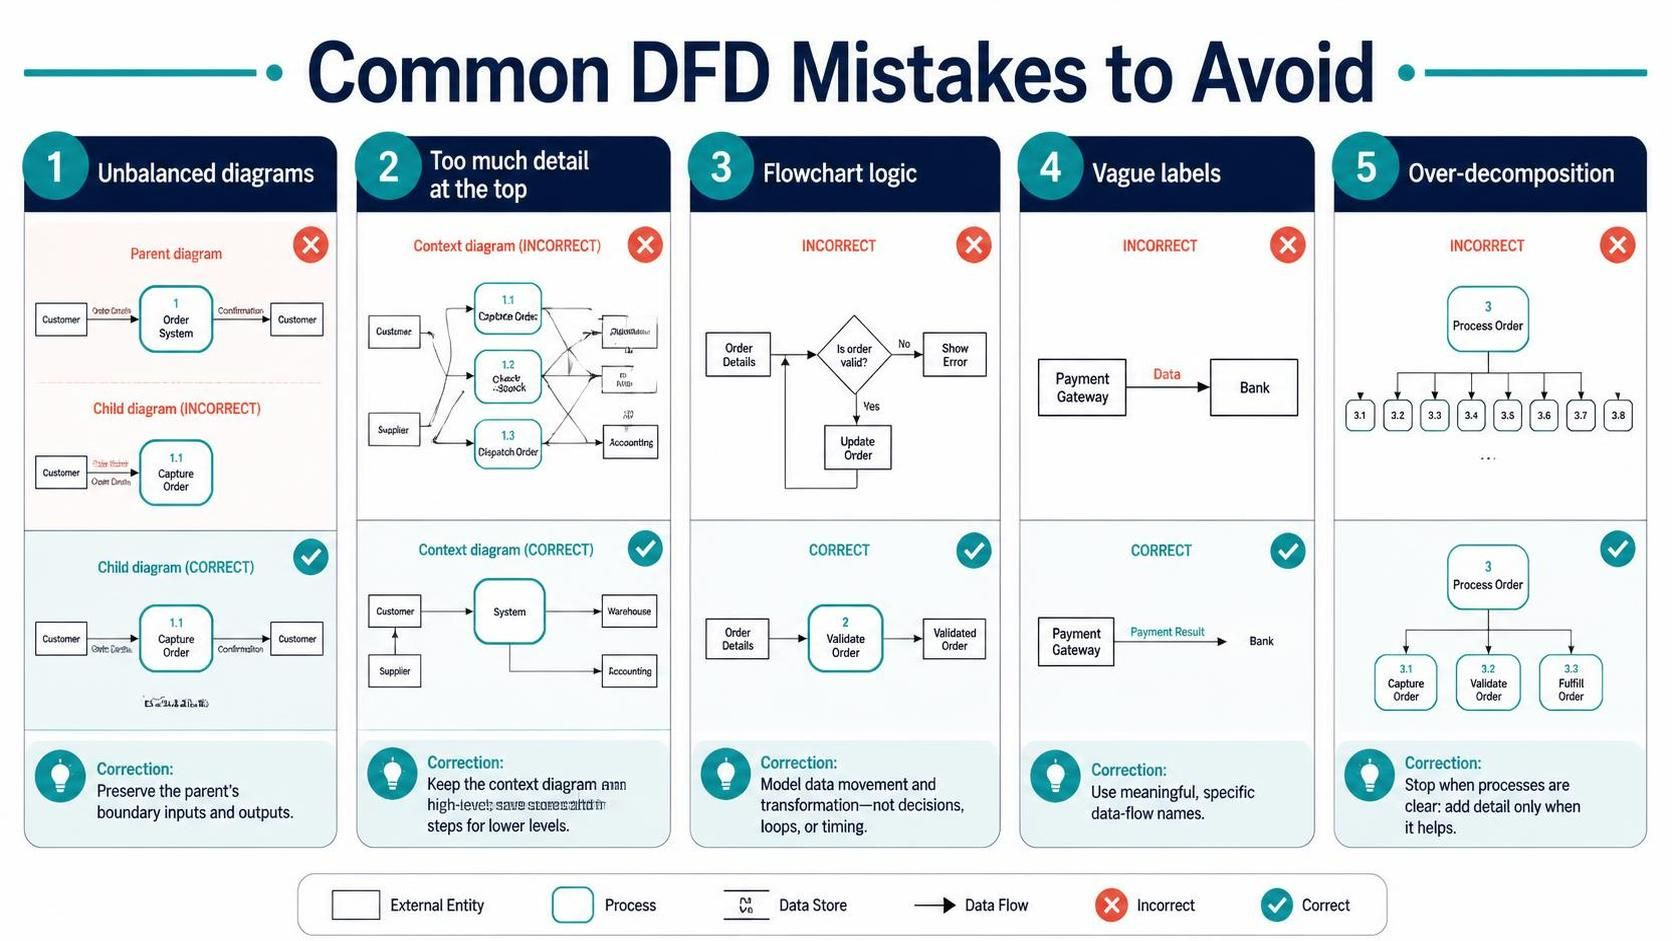
数据流图(Data Flow Diagram,简称 DFD)是系统分析与设计中不可或缺的工具,它帮助我们直观地理解数据如何在系统中流动、被处理以及存储。然而,正如我们在图表中看到的,初学者甚至经验丰富的架构师在绘制 DFD 时,经常会犯下一些看似微小却影响巨大的错误。本文将深入剖析这五大常见误区,结合 Visual Paradigm 等建模工具的最佳实践,带你从“系统边界”到“细节分解”,掌握构建高质量系统架构模型的核心技巧。
误区一:不平衡的数据流图(Unbalanced Diagrams)
在分层建模中,最核心的原则是一致性。当你将一个父级过程(Parent Process)分解为子级过程(Child Processes)时,子图必须忠实地反映父图的输入和输出。这被称为平衡原则(Balancing Principle)。
错误示例: 假设在顶层图中,系统接收了“订单详情”并输出“确认信息”。但在分解后的子图中,如果只画了“订单详情”进入,却丢失了“确认信息”的流出,或者凭空增加了新的外部输入,这就破坏了平衡。
正确做法: 无论子图内部逻辑多么复杂,其边界上的数据流必须与父级过程的输入输出完全一致。如果子图引入了新的数据流,必须在父图中进行相应的修正,或者说明这是新引入的交互。
误区二:顶层图(Context Diagram)信息过载
上下文图(Level 0 DFD)的目的是描绘系统与外部世界的宏观交互。它应该只有一个圆圈(代表整个系统),外加外部实体(如客户、供应商)和主要的数据流。
错误示例: 在顶层图中放入过多的细节,例如将具体的数据存储(Data Stores)画在外部,或者将具体的处理步骤(如“检查库存”)画在系统内部。这会导致顶层图变得拥挤不堪,失去了“全景视图”的意义。
正确做法: 保持顶层图的简洁。将具体的内部逻辑和数据存储留待下一层级的详细分解图中去展示。顶层图只回答一个问题:系统与外界交换了什么数据?
误区三:混淆流程图逻辑与数据流图(Flowchart Logic)
这是最容易混淆的概念之一。DFD 描述的是数据变换,而不是控制流。
错误示例: 在 DFD 中使用菱形表示决策(如“订单是否有效?”),或者使用带有箭头的循环箭头表示循环逻辑。这是流程图(Flowchart)的做法,而非 DFD。
正确做法: DFD 关注的是“数据从 A 流向 B,被处理成 C”。它不关心判断逻辑是 True 还是 False,也不关心循环次数。如果数据流需要被过滤,请将其视为一个独立的处理过程(例如“验证订单”),而不是画一个决策菱形。
误区四:标签模糊不清(Vague Labels)
数据流图的生命力在于其可读性。如果标签无法让人一眼看懂数据的含义,那么这个模型就是失败的。
错误示例: 使用如“数据(Data)”、“信息(Info)”或“处理结果(Result)”这样通用的词汇。例如,仅仅标注一条线为“Data”,让人无法得知具体是什么数据。
正确做法: 使用名词短语来标记数据流(例如“付款结果”、“客户订单”),使用动词短语来标记处理过程(例如“验证订单”、“计算税额”)。清晰的命名是模型沟通价值的关键。
误区五:过度分解(Over-decomposition)
虽然 DFD 支持自顶向下的分解,但分解的粒度需要适度。为了追求细节而将过程切分得过细,往往会导致模型难以阅读。
错误示例: 将“处理订单”分解为“1.1 接收数据”、“1.2 检查拼写”、“1.3 验证格式”等过于琐碎的步骤。这种微观视角往往让读者迷失在细节中,无法看到业务的全貌。
正确做法: 分解的终止条件应该是“每个过程都能被清晰地理解和描述”。如果一个过程已经足够清晰,或者继续分解只会增加阅读难度而不会增加业务逻辑的清晰度,那么就应该停止。
结语:构建清晰的系统架构
通过避免上述五大误区,你可以构建出既符合逻辑规范又具备高度可读性的数据流图。记住,DFD 的核心在于自顶向下的分解(Top-down decomposition):从宏观的“系统边界”开始,逐步深入到具体的“数据变换”细节,同时始终保持各层级之间的平衡(Balance)。
无论是使用 Visual Paradigm 进行专业的系统建模,还是使用 AI 辅助工具生成初步原型,遵循这些原则都将帮助你更准确地捕捉业务需求,设计出稳健的系统架构。